当“把积木放进碗里”的任务指令,分别下达给部署在真实机械臂上的GPT-6 Astra和Claude Fable 5.1时,在20次测试中,二者的成功次数分别为19次和8次,对应成功率95%和40%。但当任务细化为“把拼图块插入对应的凹槽”时,GPT-6 Astra的成功率滑落至10%。
这是近期独立第三方机器人基准测试平台Robocurve公布的一项实测结果。结果表明,顶尖大模型已经展现出操控物理设备的能力,但在精细操作层面仍存在短板。而这也是具身智能落地真实场景亟待突破的难题:机器人不仅要能听懂指令,更需要具备感知环境、理解空间、自主决策的能力。
在这一背景下,具身智能赛道的头部企业正试图给出解题思路。9月10日,宇树科技宣布完全开源新一代通用人形机器人基础模型UnifoLM-WLA-1.0,该模型依托大规模通用多模态感知与理解数据,融合以交互为中心的世界建模,全面提升空间感知与理解能力。在多项具身推理评测中,其表现领先国内外开源模型,亦可比肩头部闭源模型,标志着通用人形基础模型领域迎来重要突破。
2500小时真机数据训练,单模型覆盖64项任务
过去数年,机器人模型的训练大多聚焦单项任务、单一机器人本体及固定操作场景。一旦更换任务或调整环境,往往需要重新采集数据并进行训练。当前,NVIDIA GR00T、Figure Helix、Physical Intelligenceπ系列等具身智能基础模型,均致力于提升跨任务、跨环境与跨本体迁移中的泛化能力。打造通用“具身大脑”、打通多场景作业能力,已经成为行业角逐的焦点。
宇树科技也着力提升模型的泛化能力、数据利用效率和强化学习的规模效应。宇树科技宣布开源UnifoLM-WLA-1.0,代码、模型权重与数据集将陆续开放。据公司介绍,该模型参数量为6B,利用2500小时高质量真机采集数据训练,覆盖多种机器人本体与作业场景,包括宇树开源数据以及第三方机器人数据。一套模型即可完成64项差异化任务。模型兼容二指夹爪与两类灵巧手,支持不同末端执行器切换。
根据宇树给出的真机实验结果,搭载该模型的机器人可协同调动双臂、末端执行器与下半身,完成包括54项桌面操作任务以及10项全身移动操作任务。桌面场景涉及收纳餐盘、电池充电等需要精细操作的任务;全身移动操作则延伸至垃圾处理、鞋子整理、沙发整理以及在较大空间范围内取放物品等场景。
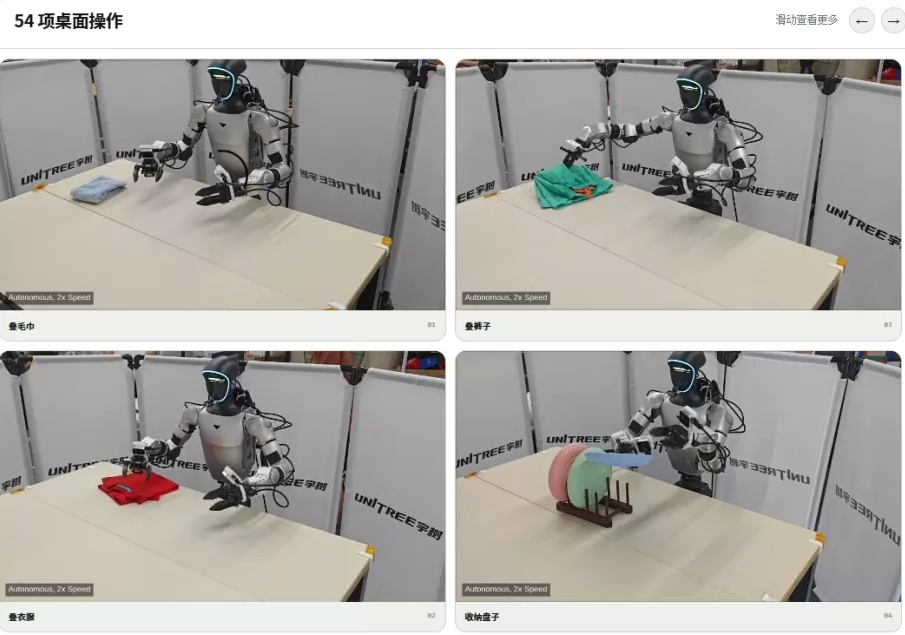
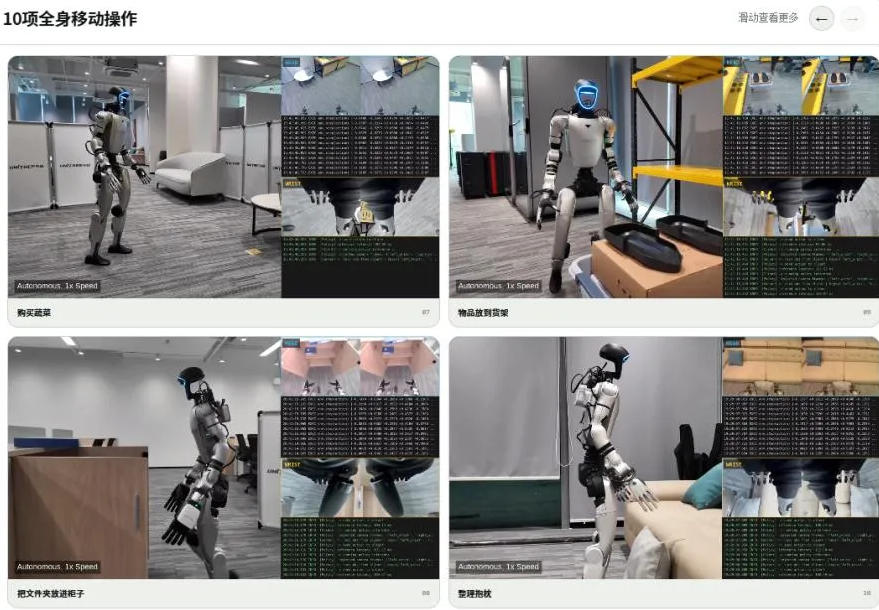
这种“一模驱动、全身协同”的设计,不仅降低了针对不同机器人本体和特定场景的训练成本,还显著提升了模型在开放环境中的指令理解能力和跨任务泛化能力,有望为通用人形机器人的规模化落地奠定技术基础。
多项具身推理指标领先,让机器人“理解世界”
机器人要在真实环境中实现“看得懂、摸得准、干得稳”,离不开对物理世界的感知与理解能力。譬如,机器人执行整理房间、铺床、整理厨房物品等任务时,往往需要根据物体状态和空间位置调整动作;当物体被移动、折叠或拿起后,环境也会随之发生改变,后续决策需要建立在更新后的场景状态之上。
围绕这一问题,宇树科技为UnifoLM-WLA-1.0设计了一套“具身推理+未来变化预测+动作学习”体系:机器人既要理解当前看到的空间和物体,也要预测一次交互可能让场景中的什么地方发生变化,再生成具体动作。
具身推理层面,宇树科技介绍,作为UnifoLM-WLA-1.0的具身推理模块,UnifoLM-ER-1-4B基于Qwen3-VL-4B,采用超过500万条训练数据,覆盖图像点预测、目标检测、多图推理、2D轨迹预测、3D目标检测及多图空间问答等任务,并与通用图文数据混合训练,在保持通用视觉语言能力的同时,全面提升具身场景下的空间理解与推理能力。
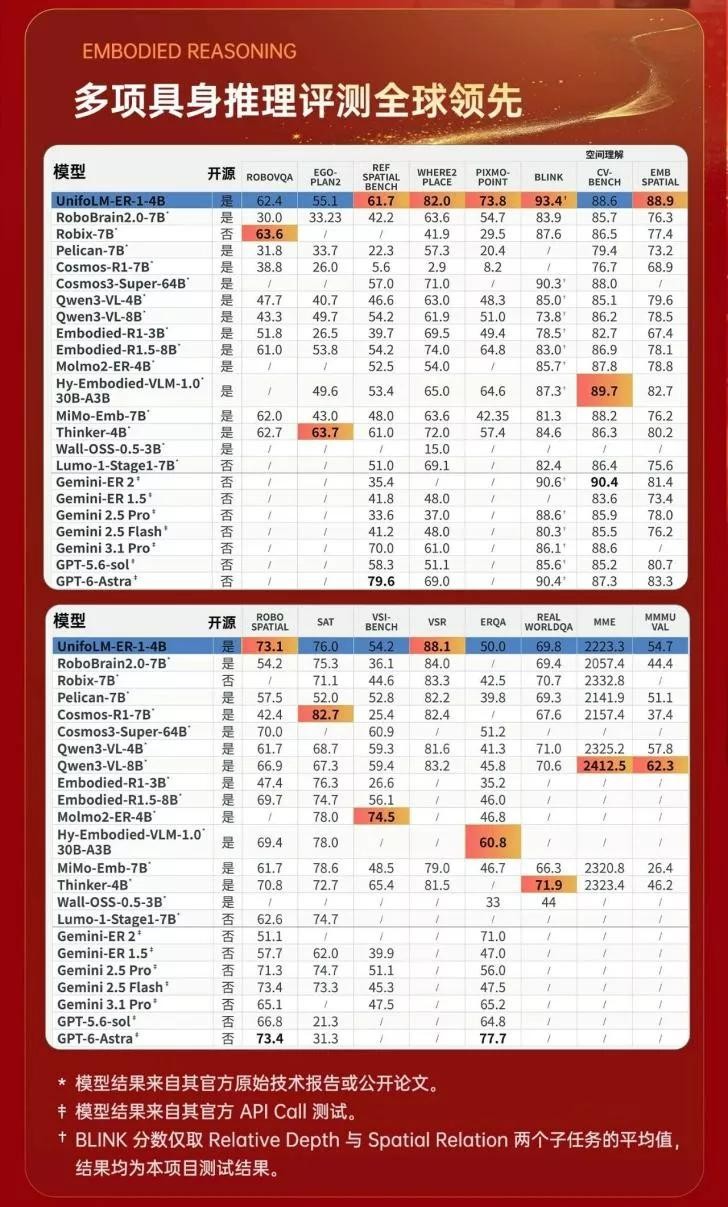
根据宇树科技公布的16项多模态感知和理解评测结果,UnifoLM-ER-1-4B在7项评测中领先其他模型。例如,其在Where2Place测试中取得82.0分,比GPT-6 Astra高出13分;Pixmo-Point为73.8分,BLINK达93.4分,EmbSpatial为88.9分,反映出模型在空间感知、场景理解等维度的系统性优势。
除了全面提升空间理解与推理能力,UnifoLM-WLA-1.0 进一步强化机器人的“预测”能力,让机器人在行动前“多想一步”。宇树科技介绍,模型以图像以及任务描述或动作为条件,预测未来场景的动态区域;训练过程中,使用光流提取未来场景变化区域作为监督信号,得到UnifoLM-ER-Flow模型。通俗而言,该模型让机器人不仅能理解环境,也能想象和预测环境将如何变化,并生成可执行的行动策略。
在离散动作学习方面,宇树将统一动作空间划分为末端执行器位姿、末端执行器关节量和下肢运动关节量三个部分,再通过残差矢量量化(RVQ)模型将连续动作转化为离散token。不同身体部分的token按照共享时间步对齐后送入模型,从而学习末端执行器位姿、夹爪或灵巧手关节以及下肢动作之间的协同关系。简单来说,这一步是把机器人连续、丝滑的动作“拆解”成一个个可被模型学习和复用的动作单元,就像把一段视频拆成关键帧来学习。
上述架构设计,构成该模型“理解世界,连接行动”的基础。通过感知理解、交互结果预测和动作生成三个环节,UnifoLM-WLA-1.0让人形机器人在面对现实环境和复杂指令时,具备更强的适应性与决策稳定性,推动具身智能从“认知智能”向“行动智能”进阶。
人形机器人迈入“大脑竞赛”阶段,宇树加码具身智能模型
宇树科技创始人王兴兴在2026世界机器人大会上表示,当前全球人形机器人产业最大的瓶颈是具身智能的泛化能力不足,核心问题在于AI模型的输入输出与真实物理世界的对齐程度不够。
实际上,宇树科技近年来持续攻坚具身大模型、场景数据采集与分析、强化学习等关键技术,同时布局WMA(World-Model-Action,世界模型-动作)与VLA(视觉-语言-动作架构)两大技术路线。按照公司规划,其目标是逐步具备场景泛化、指令泛化、动作泛化与任务泛化能力,并形成“云端模型训练—端侧推理执行—线上数据采集”的闭环。
宇树科技这一动作并非孤例。当前,全球科技巨头正加速布局物理AI赛道,行业竞争的焦点已从单一的硬件性能比拼,转向以数据规模、算法泛化能力及多模态理解为核心的“大脑”较量。
在这一进程中,开源生态已成为推动技术普惠与快速迭代的关键力量。此前,宇树科技已分别开源了通用WMA(世界模型-动作)大模型“UnifoLM-WMA-0”和通用人形机器人操作的视觉-语言-动作(VLA)大模型“UnifoLM-VLA-0”。
此次公司完全开源UnifoLM-WLA-1.0,不仅展示了其在具身智能“大脑”领域的硬实力,更有望构建“工具链—开发者—应用—数据”的生态闭环,吸引更多开发者参与底层算法优化与场景应用创新,加速人形机器人从实验室走向千行百业。(财经网)
来源:中国企业家杂志
心灵鸡汤:
标题:7项评测领先开源模型,宇树科技开源具身基座模型让人形机器人“理解世界”
地址:https://xn--vhqqb87b981b7qkyydow6d.com//jjrd/32821.html